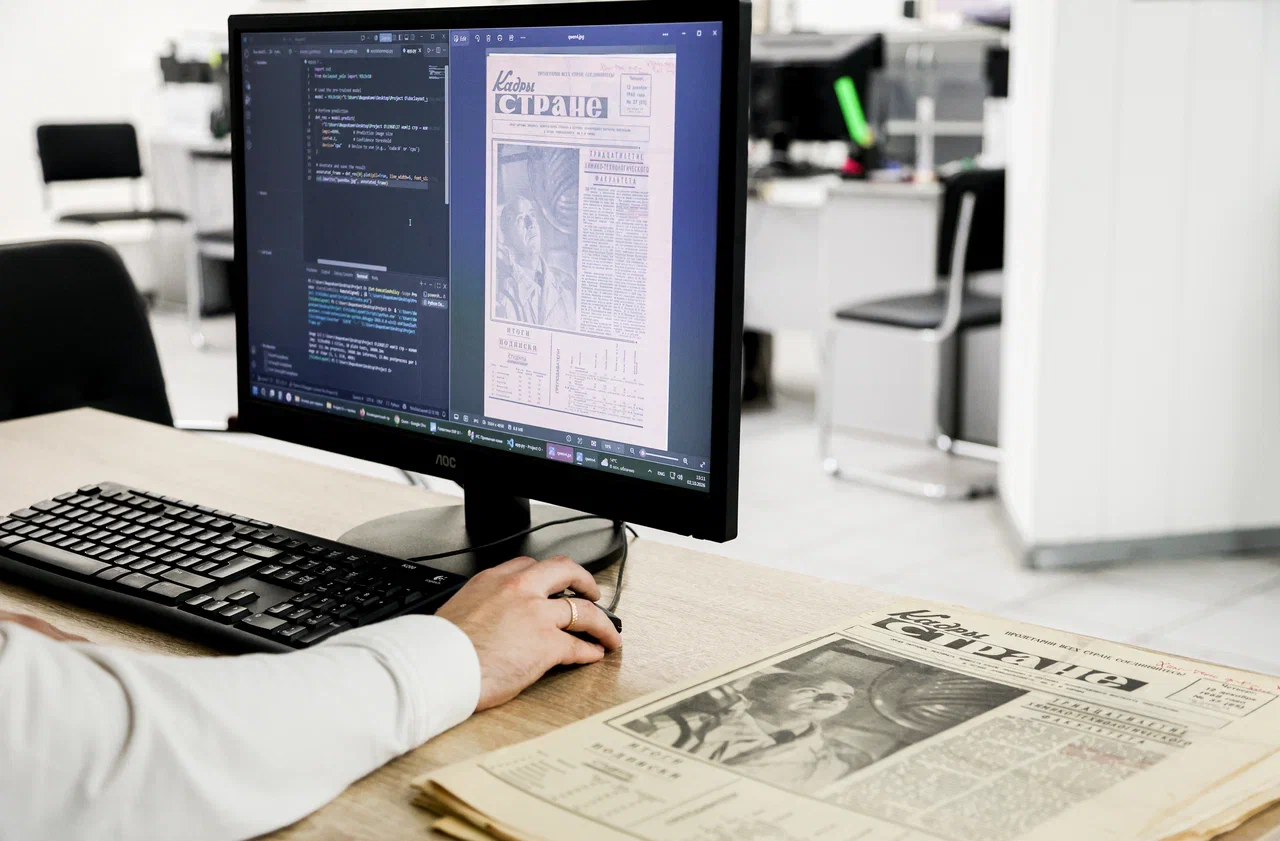
Специалисты Санкт-Петербургского государственного университета промышленных технологий и дизайна (СПбГУПТД) запатентовали программу для автоматической оцифровки архивов с физическими дефектами — пятнами, разрывами и выцветшими участками. Система на основе методов компьютерного зрения и языкового моделирования восстанавливает структуру и содержание исторических документов и других материалов, включая утраченный текст с сохранением оригинального контекста и стиля. В качестве экспериментального исследования, учеными был оцифрован ряд архивных документов Ленинградского института текстильной и легкой промышленности им. С.М. Кирова (ныне — СПбГУПТД) за 1968 год.
Разработанная программа включает визуальный и лингвистический модули. Первый отвечает за диагностику повреждений и подготовку изображения, второй — за распознавание символов и смысловое восстановление текста. Для аналогичных программ самым сложным является восстановление архивных периодических изданий из-за многоколоночной верстки. Ученым СПбГУПТД удалось создать собственную крупную языковую модель, которая верно распознает последовательность абзацев в колонках старых газет, сохраняя смысловую связность текста.
«Модель была дообучена на подшивке газеты “Кадры стране” за 1968 год, которая выпускалась в Ленинградском институте текстильной и легкой промышленности им. С.М. Кирова (ныне — СПбГУПТД). Это позволило системе “выучить” характерные для той эпохи типографские особенности и распространенные артефакты печати. В результате модель обеспечивает значительно более высокую точность распознавания, включая корректную обработку специфической лексики, аббревиатур и орфографических норм того времени», — комментирует автор разработки, ассистент кафедры интеллектуальных систем и защиты информации СПбГУПТД Никита Сиротенко.
На начальном этапе программа анализирует скан документа целиком и разделяет его на смысловые блоки — заголовки, основной текст, изображения, таблицы. Далее каждый текстовый фрагмент проходит визуальную очистку: повышение контрастности, заполнение микроразрывов в буквах и бинаризацию, которая автоматически определяет оптимальный порог отделения текста от пожелтевшего со временем фона. После фильтрации мелких артефактов очищенное изображение передается в OCR-движок для распознавания символов.
На завершающем этапе созданная разработчиками вуза крупная языковая модель (LLM) решает задачи структурного и смыслового восстановления текста. Дополнительный алгоритм корректно обрабатывает слова, разорванные дефисом при переносе, а также восстанавливает слова, разделенные физическими повреждениями бумаги. Кроме того, LLM анализирует пространственное расположение блоков на странице газеты, объединяет разорванные заголовки и выстраивает правильную последовательность абзацев в многоколоночной верстке.
Программа предназначена для специалистов архивов и библиотек, цифровых археологов и исследователей для массовой оцифровки исторических документов. В перспективе программа может быть использована в юриспруденции и криминалистике для восстановления читаемости поврежденных договоров, расписок, завещаний или писем, которые фигурируют в судебных делах, и вещественных доказательств, найденных на месте преступления. А также в сфере страхования для обработки документов, поврежденных в результате чрезвычайных ситуаций, например, потопов или пожаров.
Фото: СПбГУПТД
Источник: Минобрнауки России